ICS
四、处理器体系结构
4.1 Y86-64指令集体系结构
4.1.1 程序员可见的状态
程序员:用汇编代码写程序的人或产生机器级代码的编译器
可见状态:每条指令都会读取或修改处理器状态的某些部分
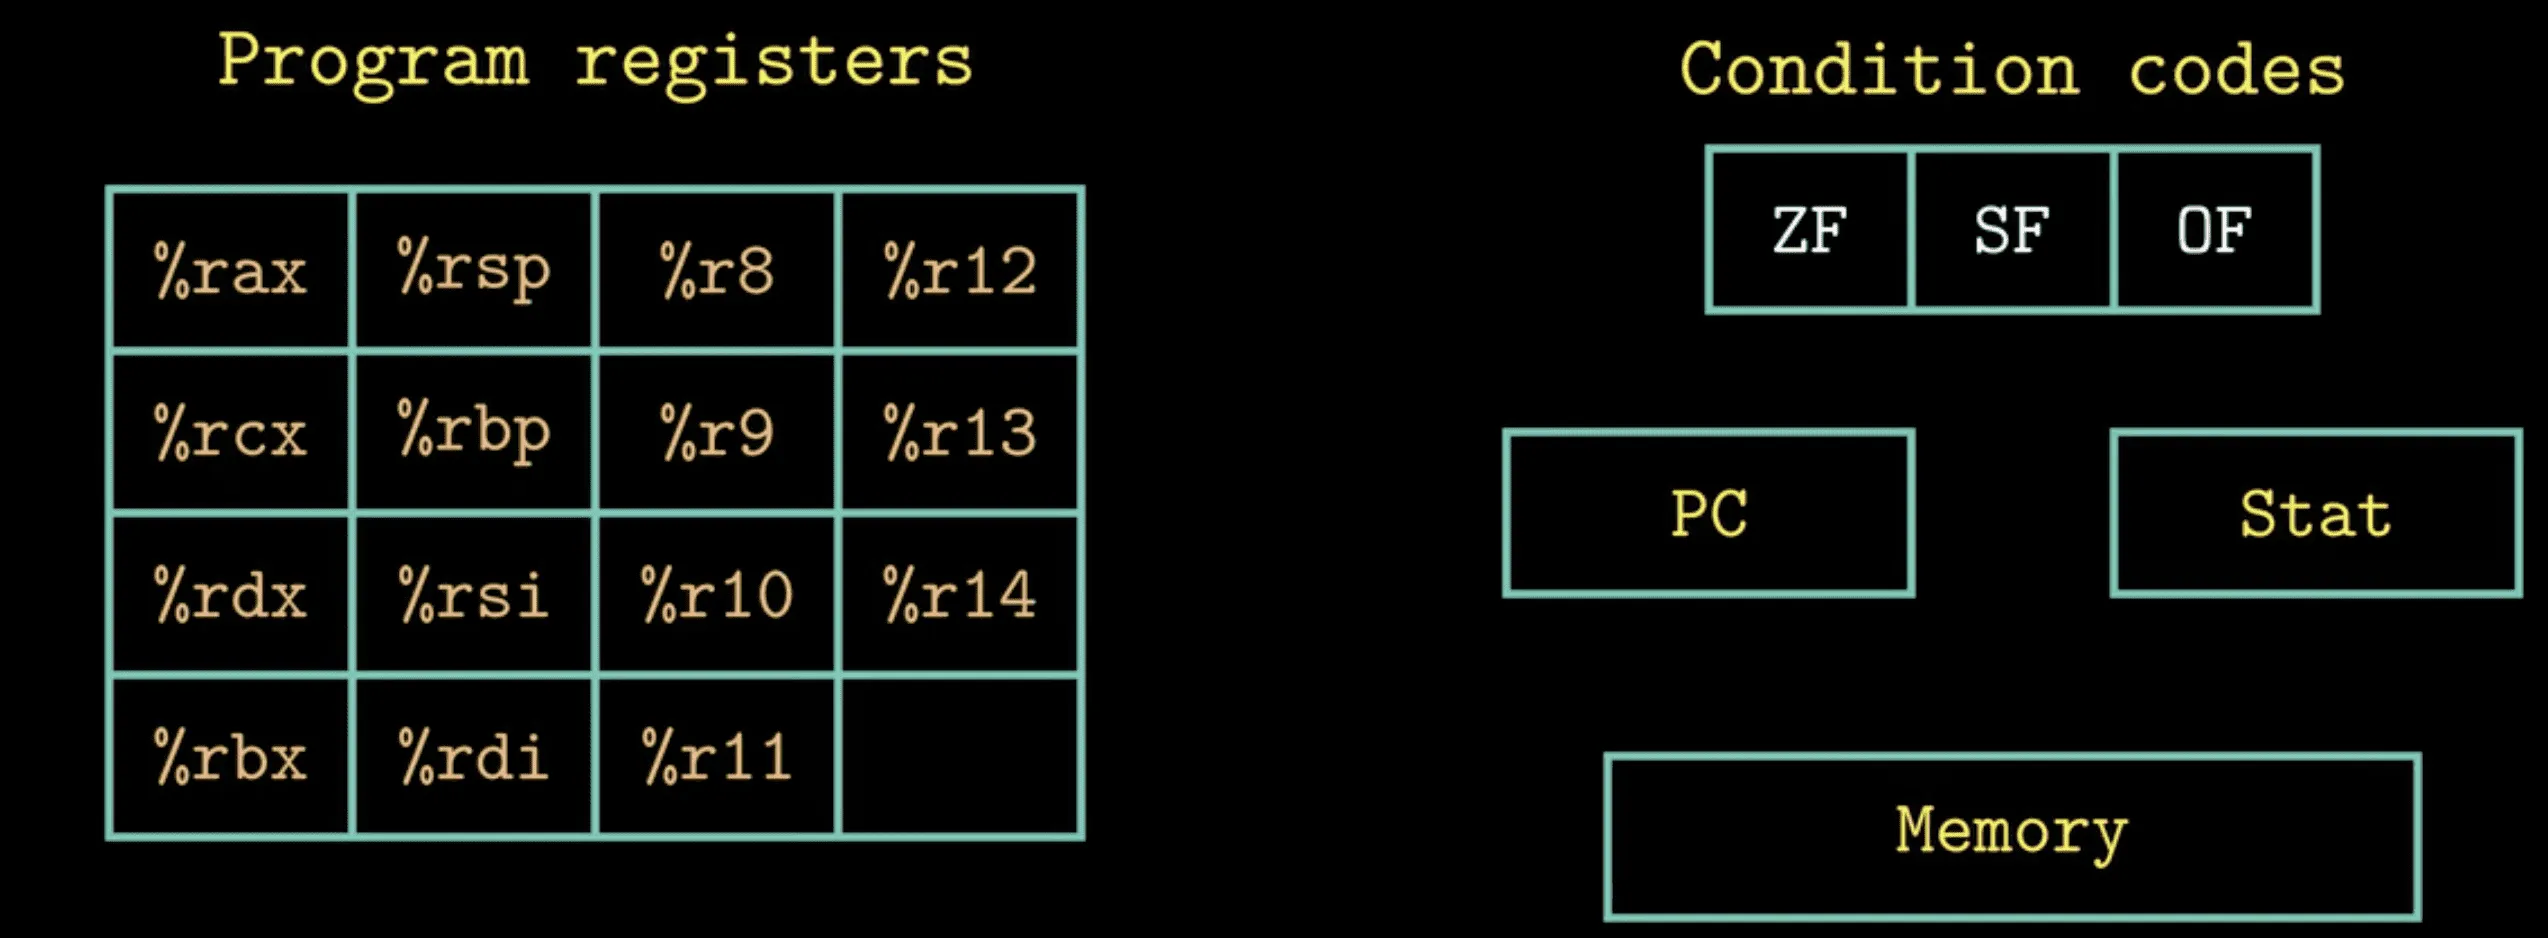 15个程序寄存器,每个程序寄存器存储一个64位的字(8字节),寄存器%rsp被出栈,入栈,调用和返回指令作为栈指针。3个1位的条件码ZF,OF,SF,程序计数器PC存放当前正在执行指令的地址
4.1.2 Y86-64指令
movq指令被分成了4个不同的指令:irmovq,rrmovq,mrmovq,rmmovq,源可以是立即数(i),寄存器(r)或内存(m)。指令的第一个字符表示源的类型,第二个表示了目的的类型。同x86-64,我们不允许将内存直接传送到另一个内存,也不允许将立即数传送到内存。
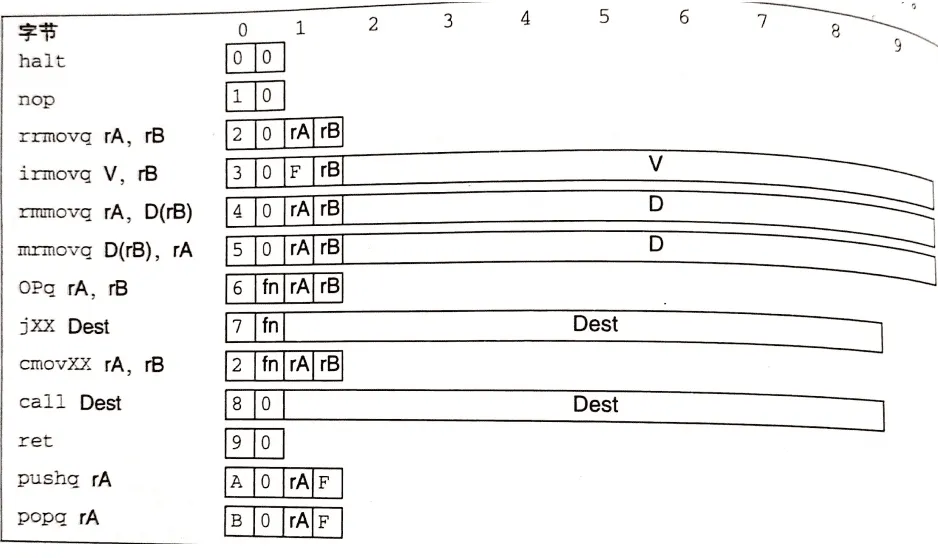 halt 停止指令的执行
nop 空操作
4个整数操作指令addq,subq,andq,xorq
7个跳转指令(图中的jxx)jmp、jle、jl、je、jne、jge、jg分支条件和x86-64一致。
6个条件传送指令(图中的cmovxx):cmovle、cmovl、cmove、cmovne、cmovge和cmovg、格式与rrmovq一样,但是只有当条件码满足约束才会更新寄存器的值。
call 将返回地址入栈,然后跳到目的地址。ret指令从这样的调用中返回。
pushq和pullq实现了入栈和出栈。
4.1.3指令编码
每条指令需要1~10个字节不等,每条指令的第一个字节表示指令的类型,这些字节分为两个部分,每部分4位:高四位是代码部分,低四位是功能部分(fn)。代码值位0~0x8
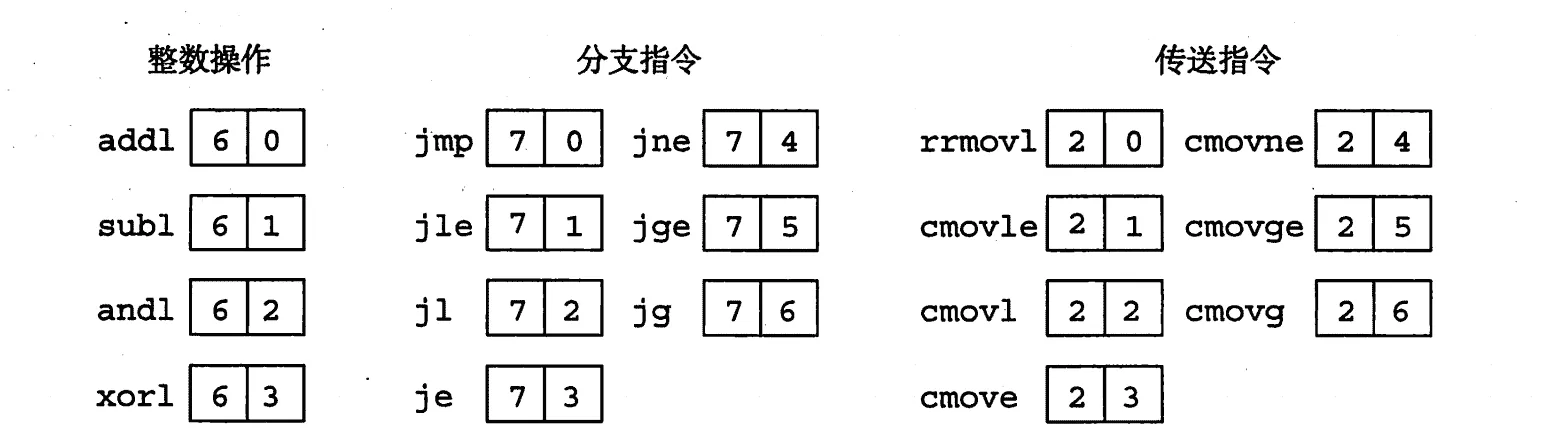 rrmovq与条件传送有相同的指令代码,可以把它看作是无条件传送,功能代码都是0
寄存器标识符
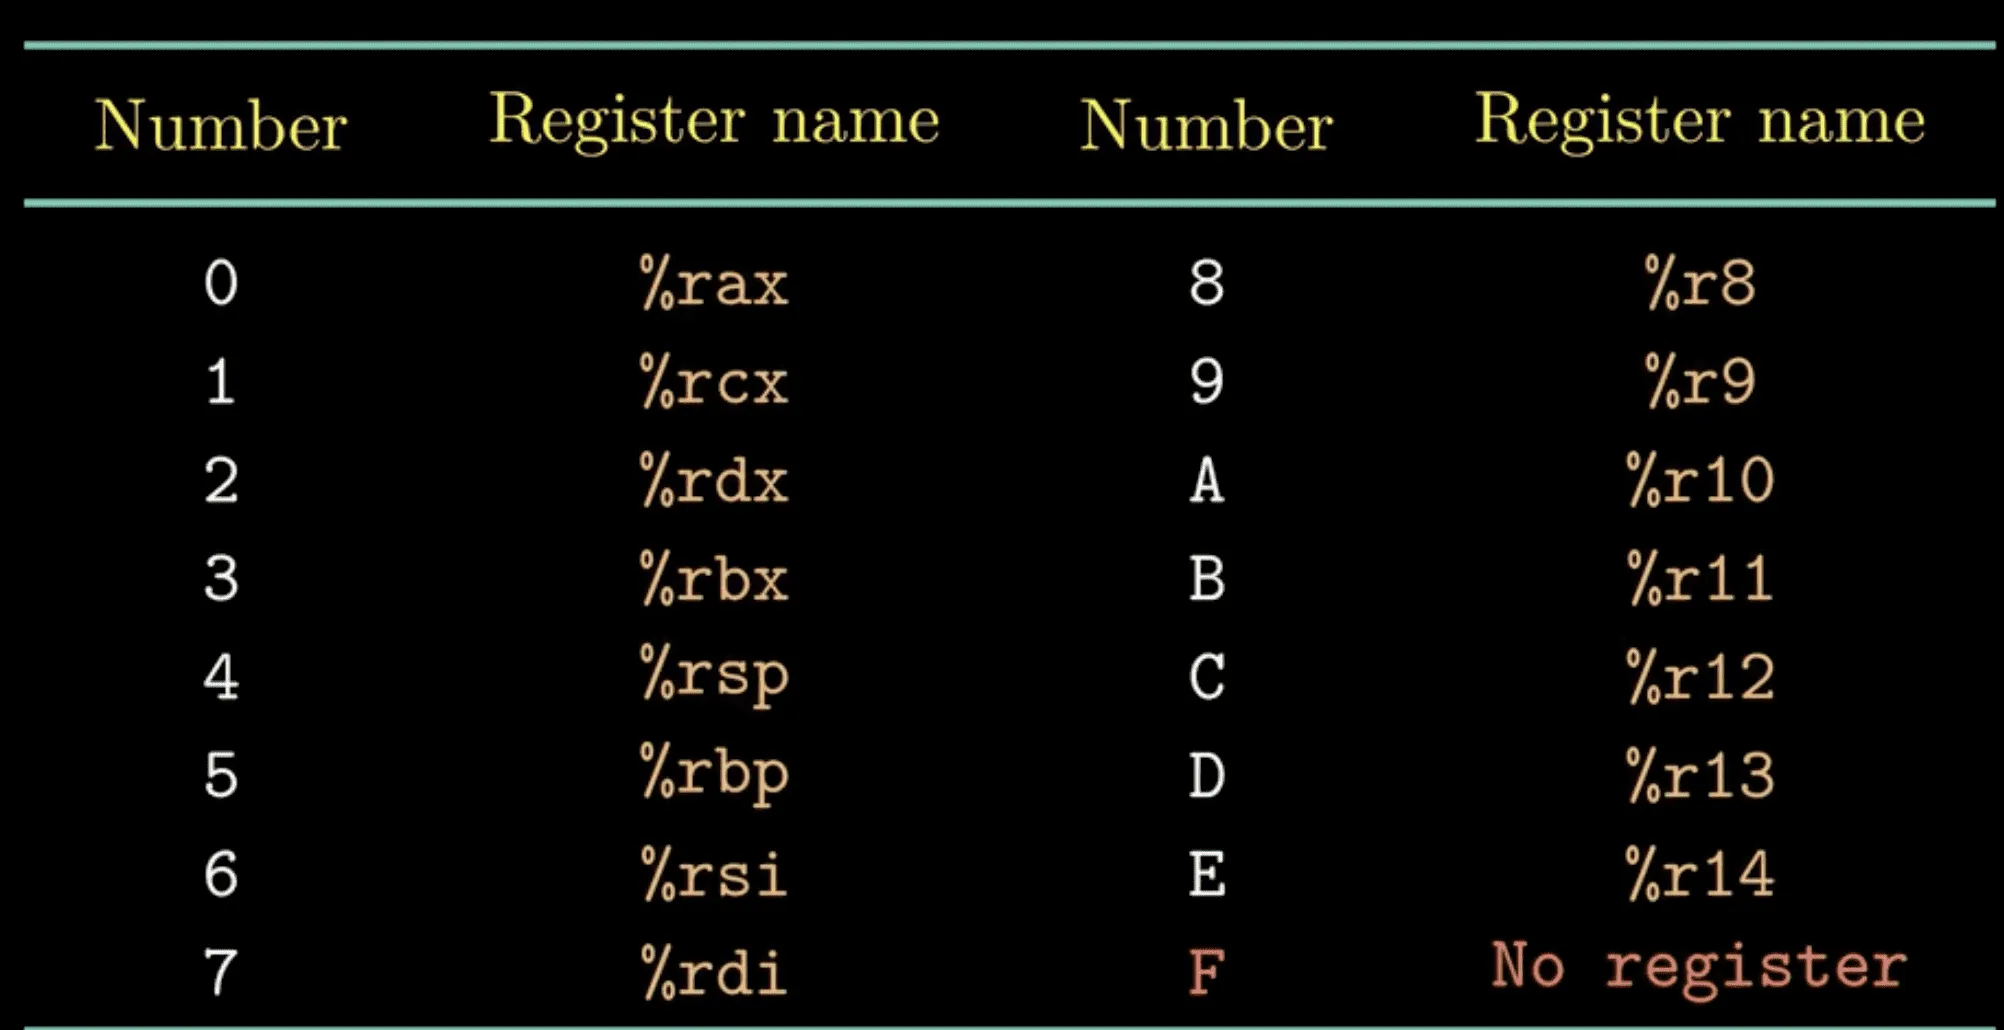 rA和rB被称为寄存器指示符字节,指定标识符对应的寄存器。不需要寄存器的则将r设置为0xF。
有些指令需要一个附加的8字节常数字,这个字能作为irmovq的立即数,rmmovq和mrmovq的地址指示符的偏移量,以及分支指令和调用指令的目的地址。(分支指令和调用指令的目的是一个绝对地址,而非相对寻址)
比如对 rmmovq %rsp,0x123456789abcd(%rdx);先填充为8字节得00 01 23 45 67 89 ab cd在小断法反序成cd ab 89 67 45 23 01 00,连起来得指令的编码为40 42 cd ab 89 67 45 23 01 00.
字节编码有唯一的解释。
旁注 RISC和CISC
二者主要区别在于CISC指令数量很多而RISC少,RISC代码固定为4字节,RISC没有条件码,RISC寻址简单,RISC只有load和store允许内存调用,RISC细节可见。RISC指令延迟短,RISC比较简单,故代码长度一般更长
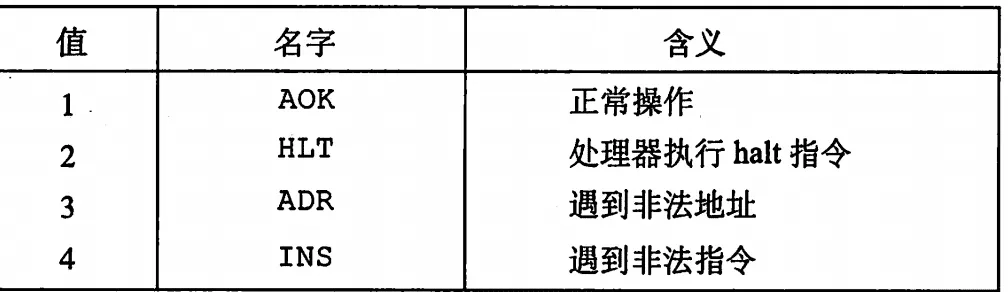
4.1.4 Y86-64异常
状态码Stat描述程序运行的总体状态。
4.1.5 Y86-64程序
与x86-64的汇编代码相比,Y86-64需要将常数加载到寄存器。从内存中读取数值并与一个寄存器相加时,Y86-64需要两条指令,x86-64只需要一条。
4.2 逻辑设计和硬件控制语言HCL
逻辑门
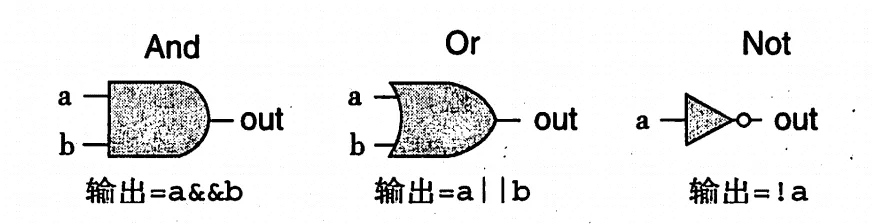 组合电路要求:
1)每个逻辑门的输入必须连接到系统输入或者存储器输出或逻辑门输出上
2) 逻辑门的输出不能连在一起
3)网必须是无环的
HCL:
数据类型:bool, int
操作
简单的布尔表达式:    bool out = (s&&a)||(!s&&b)
情况表达式(多选器) word out = [select1 : expr1, select2 : expr2 ... ]
集合关系 bool s = code in { item1, item2, ... }
与C语言逻辑运算的区别
组合电路输出持续响应输入的变化
HCL无C语言中的“短路”,不会部分求值
存储器 分为时钟存储器和随机访问存储器
4.3 Y86-64程序的实现
描述一个SEQ的处理器
4.3.1 将处理组织成阶段
1.取指(fetch):从内存读取指令字节,地址为PC的值。从指令中抽取出指令指示符字节的两个四位部分,icode(指令代码)和ifun(指令功能)。可能取出一个寄存器指示符字节,指明一个或两个寄存器操作数指示符rA和rB。还可能取出个8字节常数字valC,计算出下一条指令地址valP。即valP等于PC+已执行操作的字节
2.译码(decode):从寄存器文件读入最多两个操作数,得到valA和/或valB
3.执行(execute)ALU进行指令指明的操作或对栈指针进行增减,同时可能设置条件码
4.访存(memory) 将数据写入内存或读出数据
5.写回(write back)将结果写回寄存器文件
6.更新PC(PCupdate)将PC设置成下一条指令的地址
例:
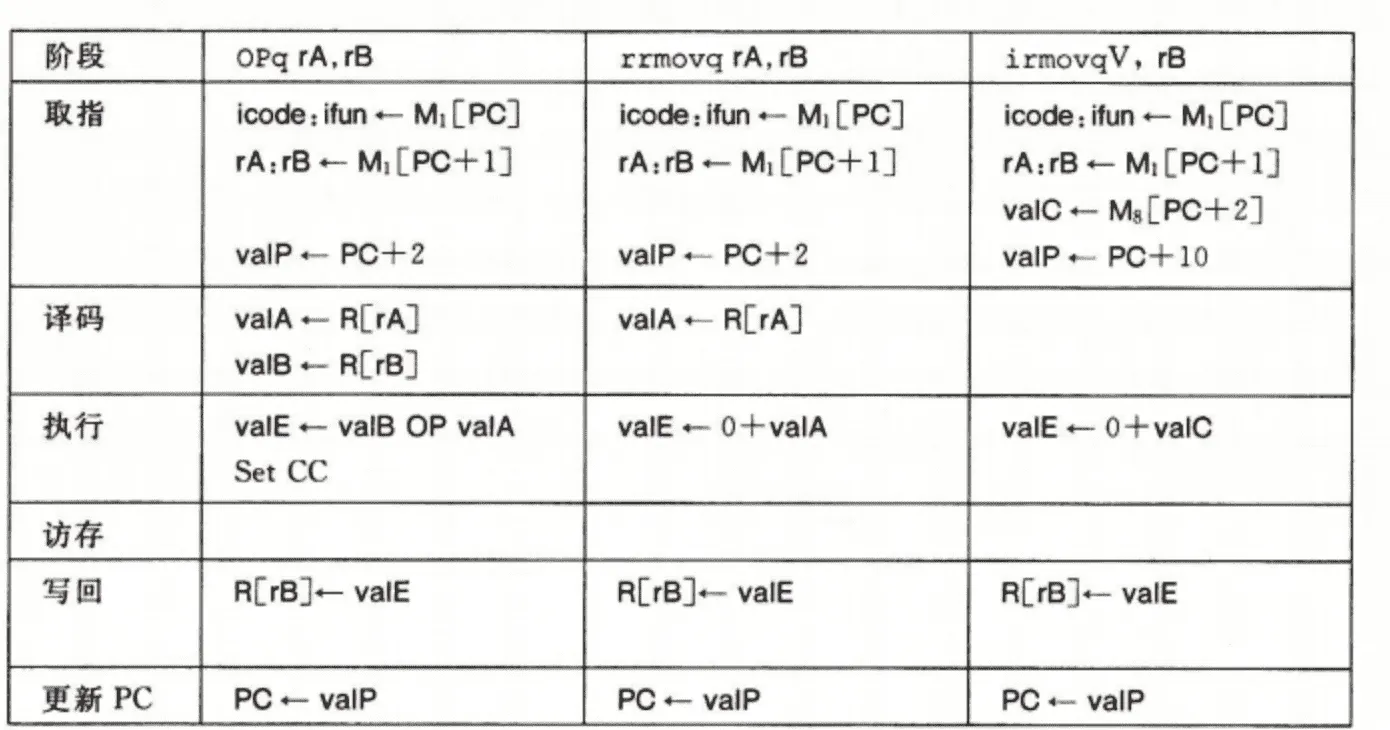
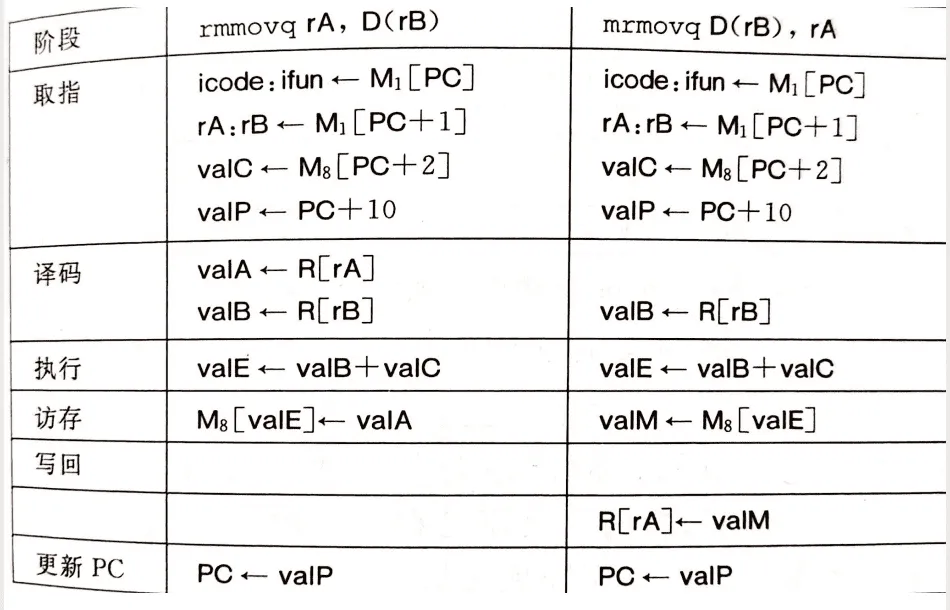
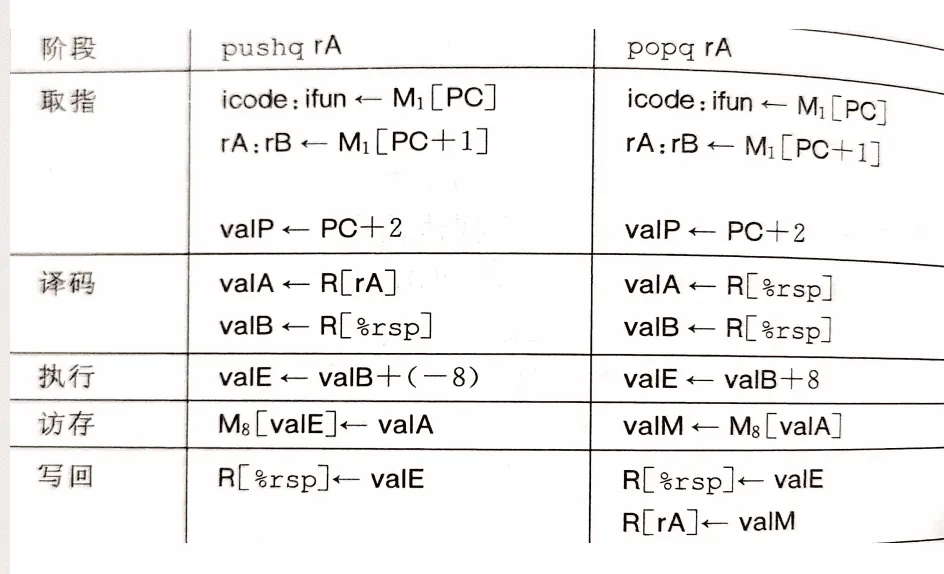
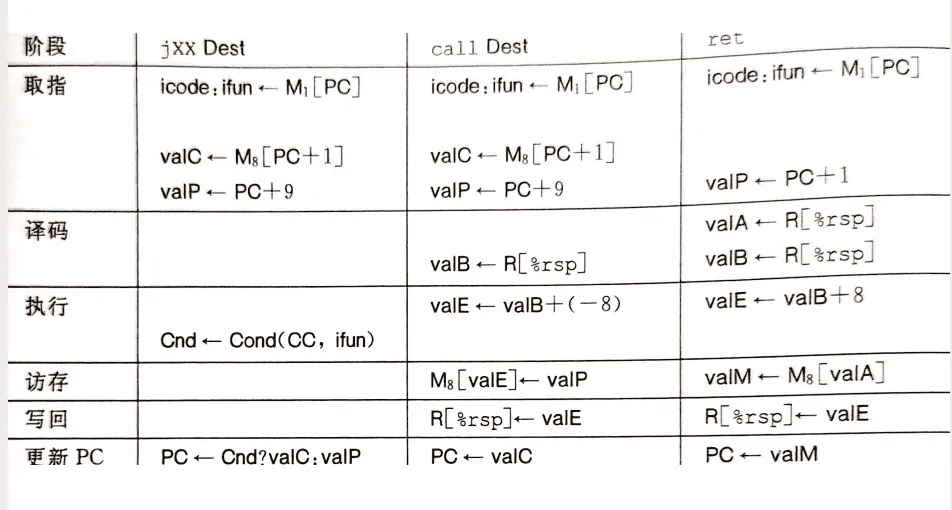 其中PC 、rA、rB、OP等在运算中都是具体的值。
整数操作指令遵循上面列出的通用模式。
如
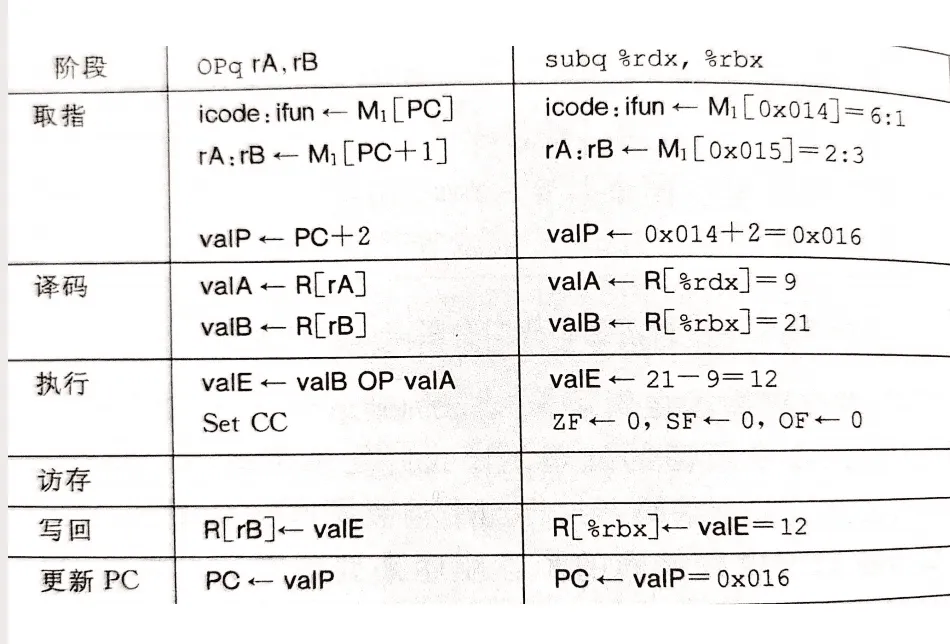 其他的操作同理。
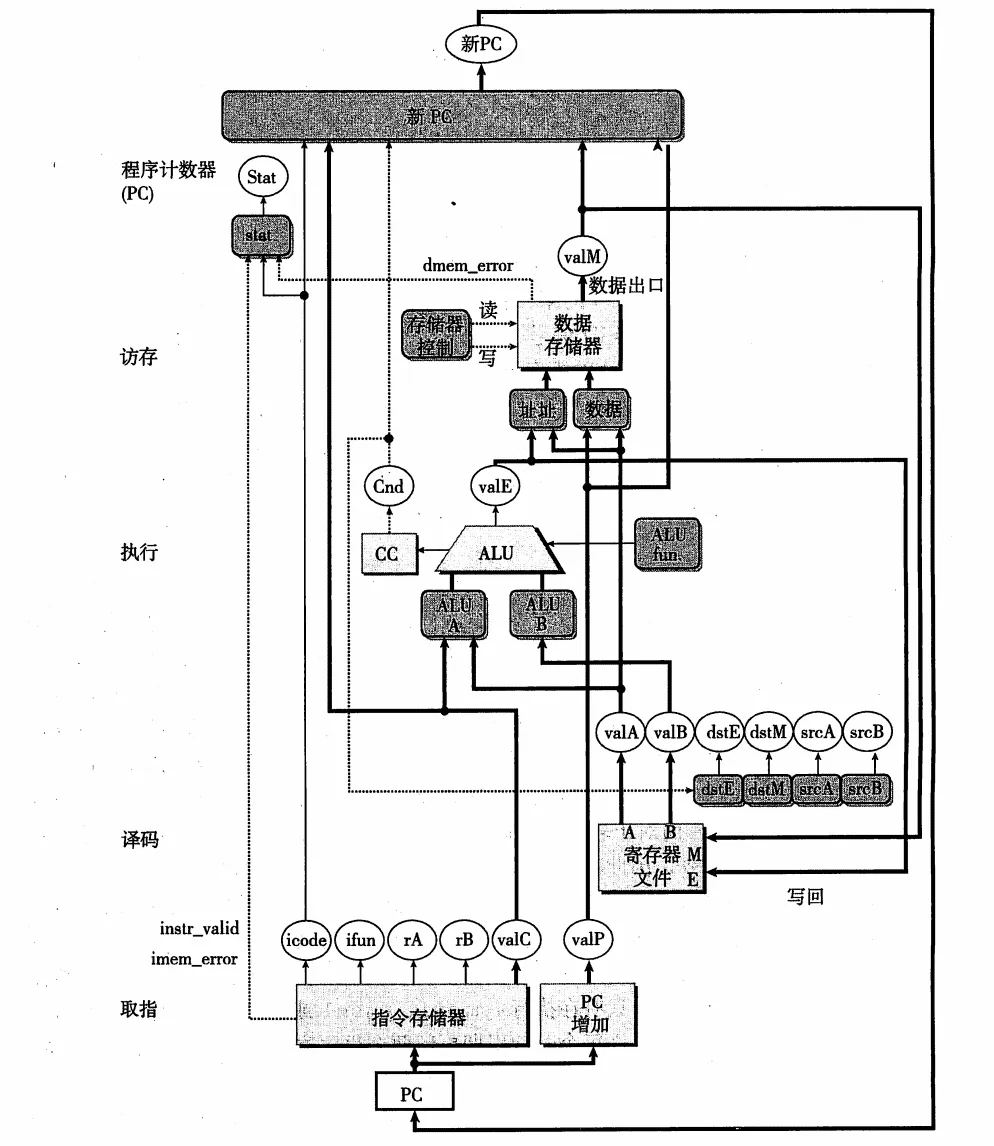
4.3.2 SEQ硬件结构
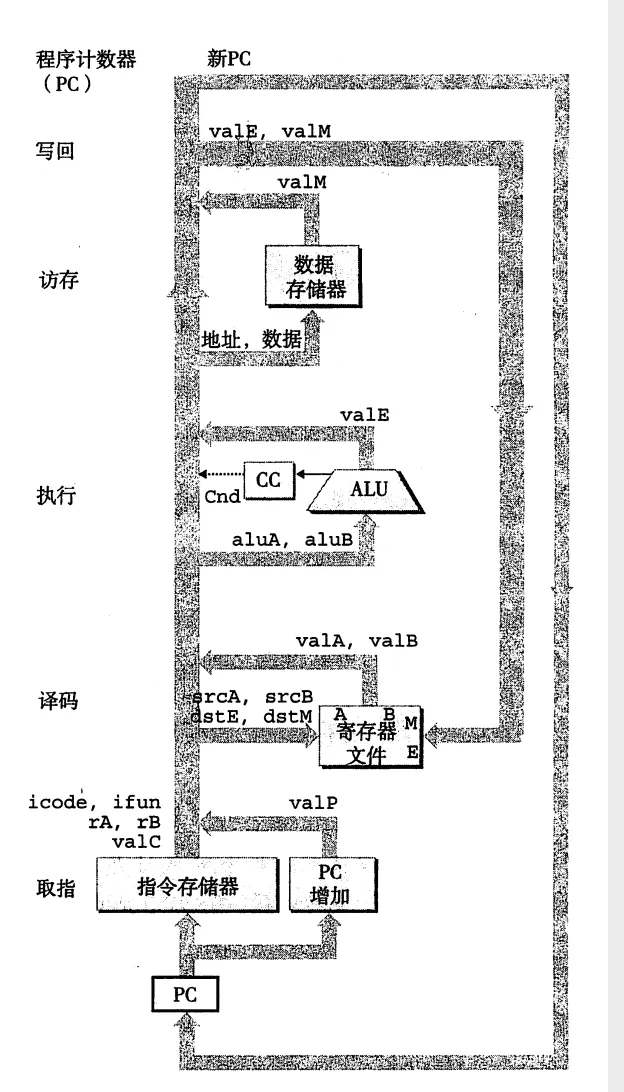
取指:将程序计数器寄存器作为地址
译码:寄存器文件有两个读端口A和B,从这两个端口分别读取寄存器值valA和valB
执行:ALU执行,CC为条件码寄存器
访存:访问内存,进行写入或者读
写回:寄存器文件有两个写端口,E用来写入ALU计算出的值,M用来写从数据内存中读出来的值
PC更新:valP:下一条指令的地址;valC:调用指令或跳转指令制定的目标地址;valM:从内存读取的返回地址
4.3.3 SEQ的时序
原则:从不回读(处理器从来不需要为了完成一条指令的执行而去读由该指令更新了的状态) 例:没有指令既设置又读取条件码
4.3.4 SEQ阶段的实现
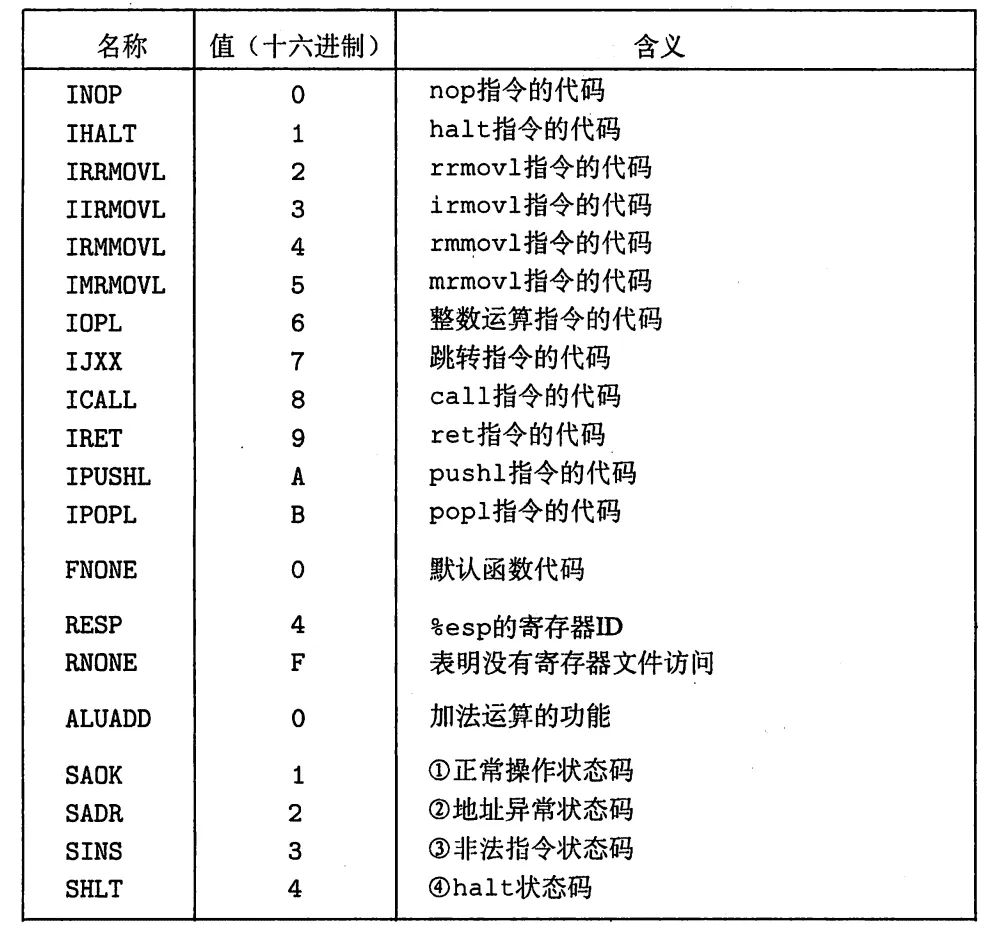 1.取指阶段:以PC作为字节0的地址,一次从内存读出10个字节。第一个字节被解释成指令字节,然后icode和ifun的控制逻辑块计算指令和功能码。
instr_valid:指令非法
need_regids:包含寄存器指示符字节
bool need_regids={
    icode in{IRRMOVLQ,IOPQ,IPUSHQ,IPOPQ,
        IIRMOVQ,IRMMOVQ,IMRMOVQ};
}need_valC:包含常数字节
剩下9个字节是寄存器指示符字节和常数字节的组合编码。
若need_regids为1,则字节1被分开装入rA和rB中,否则设为0xFF
产生常数valC根据need_regids的值由2~9或者1~8产生
 PC值为p+1+r+8i(r为need_regids的值,i为need_valC的值,p为初始PC)
2.译码和写回阶段:从寄存器文件中读取数据,寄存器文件有四个端口,读端口的地址输入为srcA和srcB,写端口的地址输入为dstE和dstM。读出的数值通过valA和valB输出,写入的数值通过valM和valE
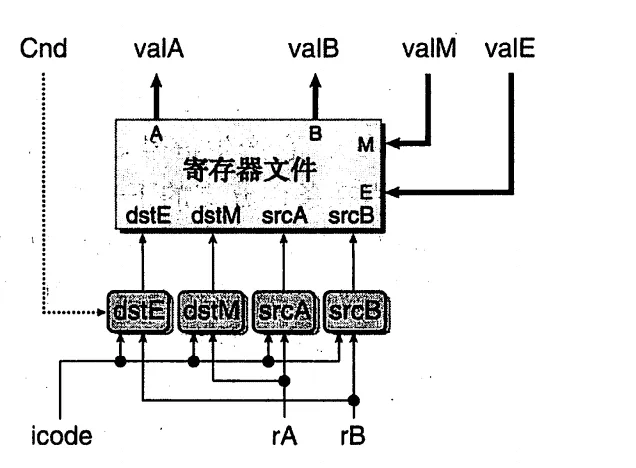
word srcA={
    icode in {IRRMOVQ,IRMMOVQ,IOPQ,IPUSHQ}:rA;
    icode in{IPOPQ,IRET}:RRSP;
    1:RNONE;#Don't need register
}
#warning :conditional move not implemented correctly here
word destE={
    icode in{IRRMOVQ}:rB;
    icode in {IIRMOVQ,IOPQ}:rB;
    icode in { IPUSHQ,IPOPQ,ICALL,IRET}:RRSP;
    1:RNONE;#Don't need register
}
3.执行阶段:
对输入的aluA和aluB进行算数与逻辑运算
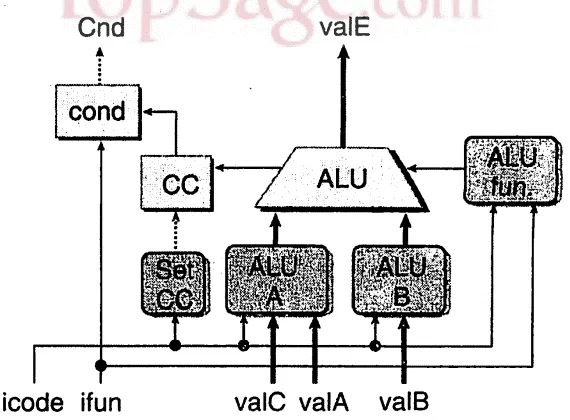
word aluA={
    icode in{IRRMOVQ,IOPQ }:valA;
    icode in{IIRMOVQ,IRMMOVQ,IMRMOVQ}:valC;
    icode in {ICALL,IPUShQ}:-8;
    icode in {IRET,IPOPQ}:8;
    #other instructions don't need ALU
}
bool set_cc = icode in {IOPQ};//仅运算改变条件码寄存器
4.访存阶段
从内存读入或者把数据写入内存中
进行读时产生valM
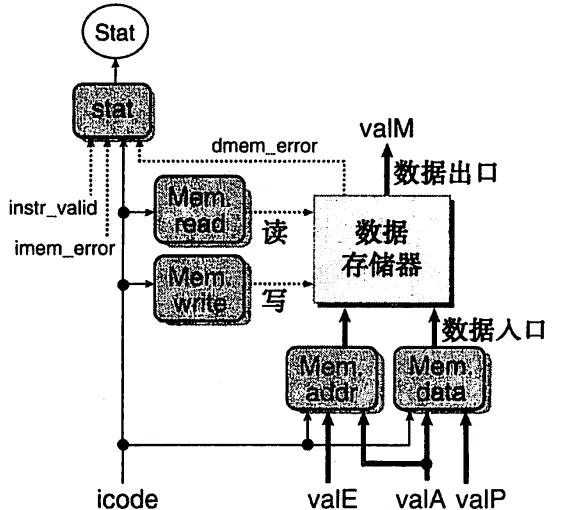
word mem_addr=[
    icode in {IRMMOVQ,IPUSHQ,ICALL,IMRMOVQ}:valE;
    icode in{IPOPQ,IRET}:valA;
#Other instructions don't need address

];
bool mem_read=[
    icode in{IMRMOVQ,IPOPQ,IRET};
]//只读数据
5.更新PC状态
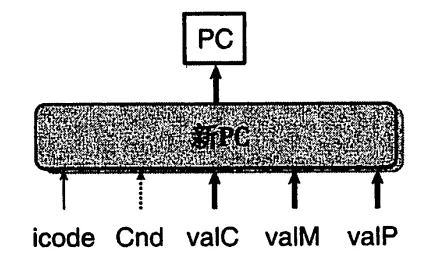 新PC可能是valC,valM或valP
当正在执行call或者满足跳转条件即将跳转时,PC为valC,正在执行RET,valM,其他为当前PC加当前指令长度
word new_PC=[
    icode == ICALL:valC;
    icode == IJXX&&Cnd:valC;
    icode == IRET:valM;
    #default
    1:valP;
]
总结
4.4 流水线的通用原理
我们用每秒千兆条指令(GIPS),也就是每秒十亿条指令,为单位来描述吞吐量。延迟为吞吐量的倒数。
吞吐量=1/(执行时间+延迟)
画出流程图进行分析
v指令的转移由时钟信号决定
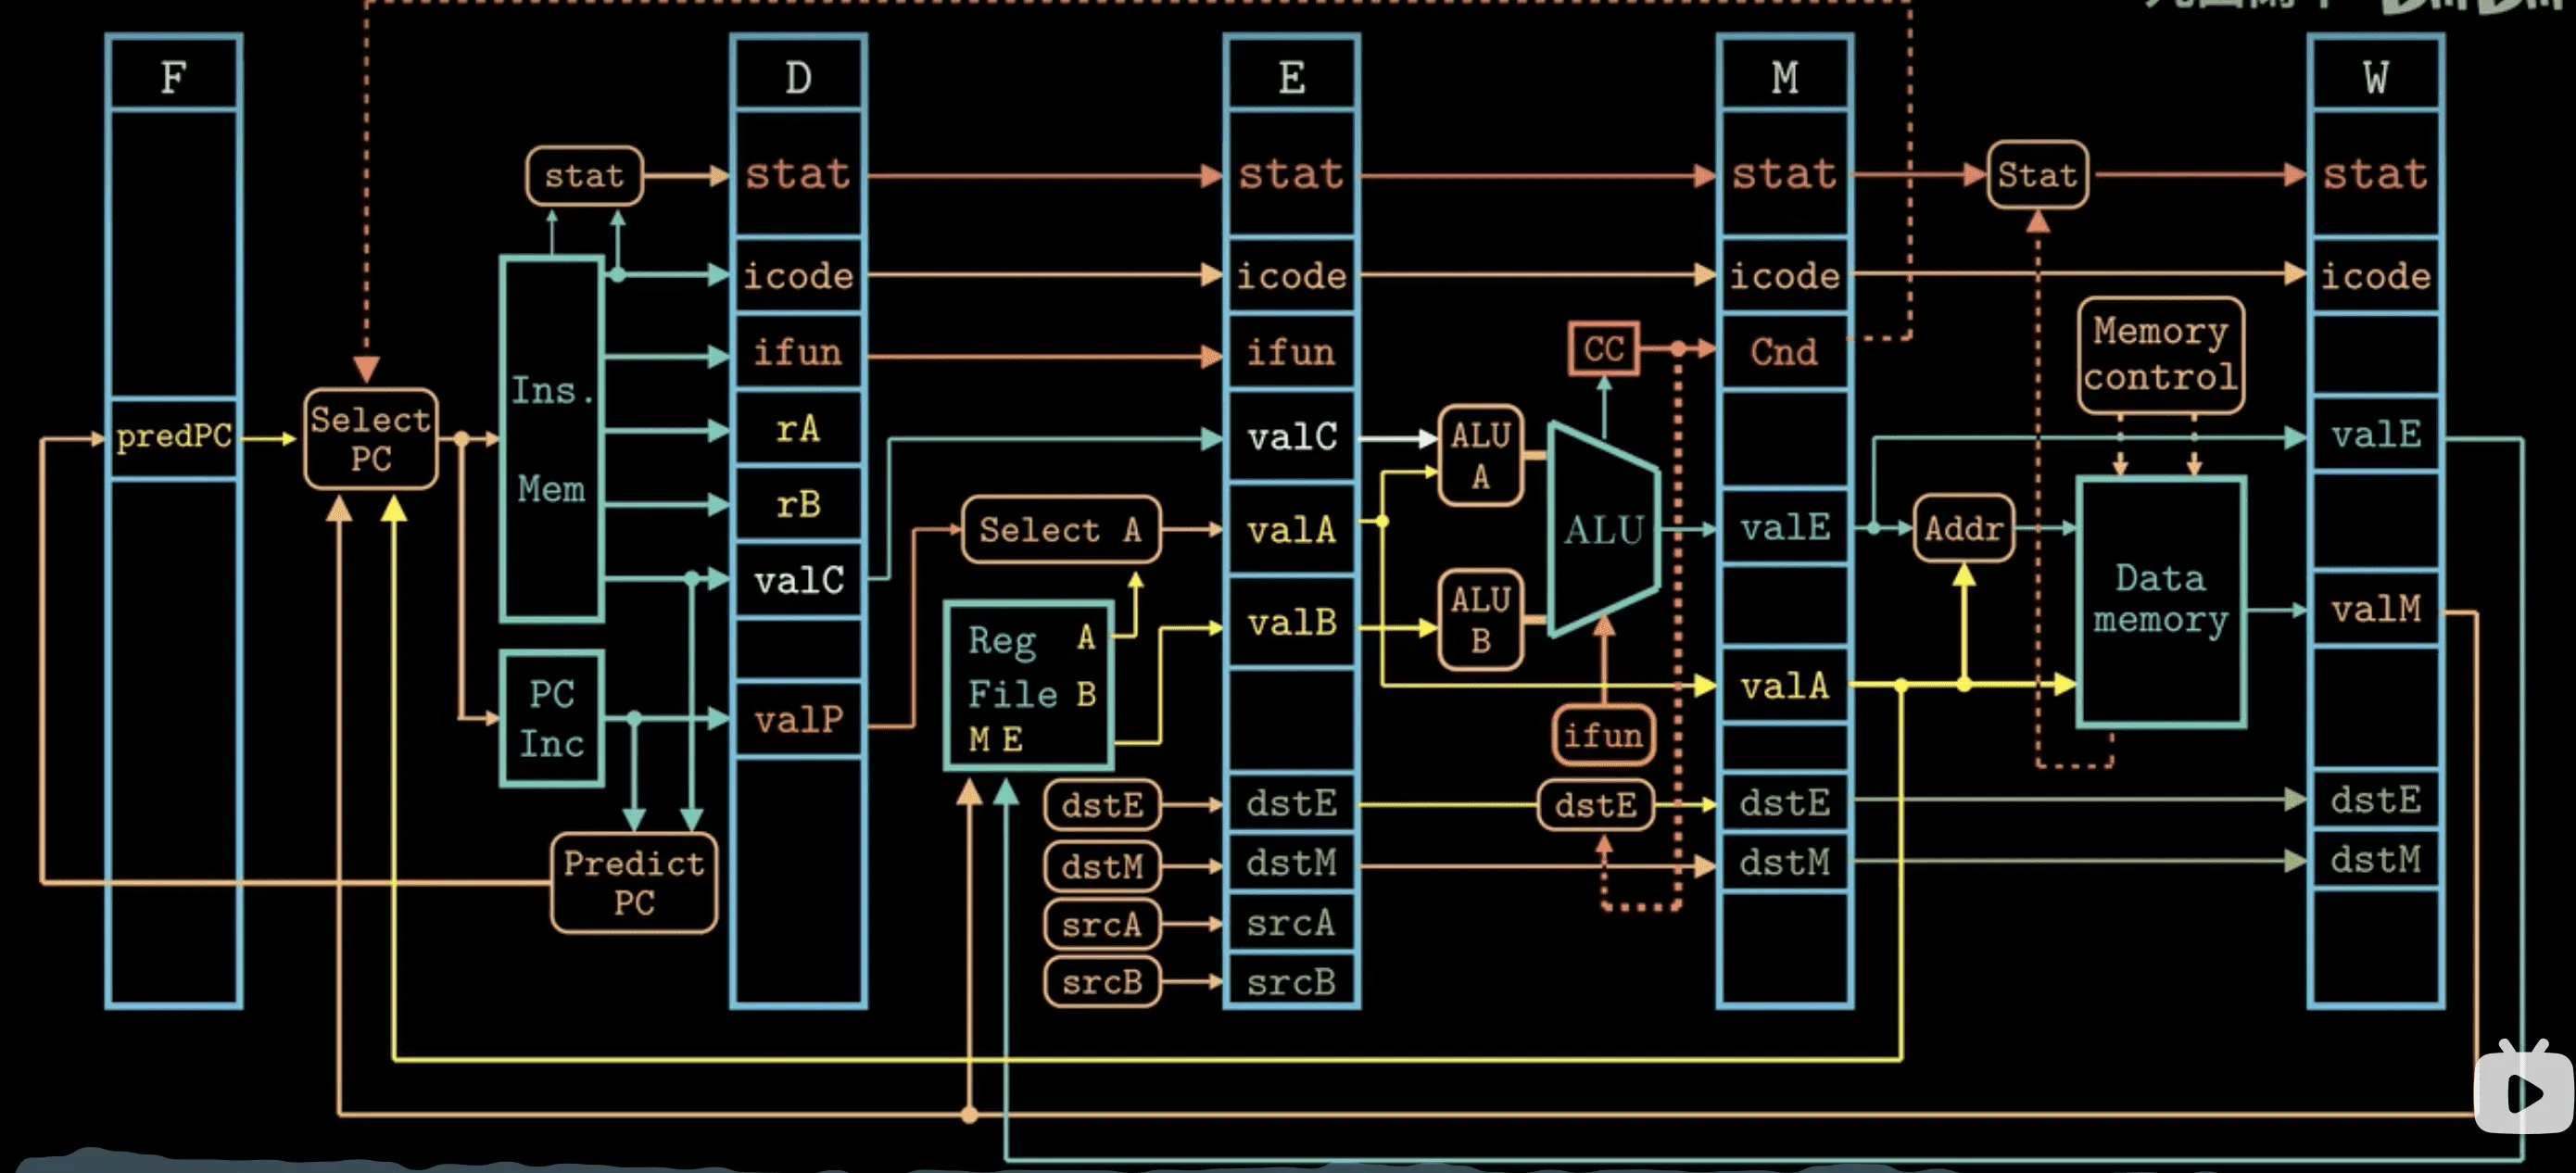
4.5 Y86-64的流水线实现
将更新PC放在一个时钟周期的开始时执行
实现方法:创建一个寄存器来保存指令在执行过程中产生的信号,标号为前面加个p:电路重定时
流水线寄存器:
F:保存程序计数器的预测值
D:位于取指和译码之间,保存最新取出的指令的信息
E:位于译码和执行之间,保存关于最新译码的指令和从寄存器文件中读出的值的信息
M :位于执行和访存之间,保存最新执行的指令的结果
W:位于访存和反馈路径之间
 流水线冒险
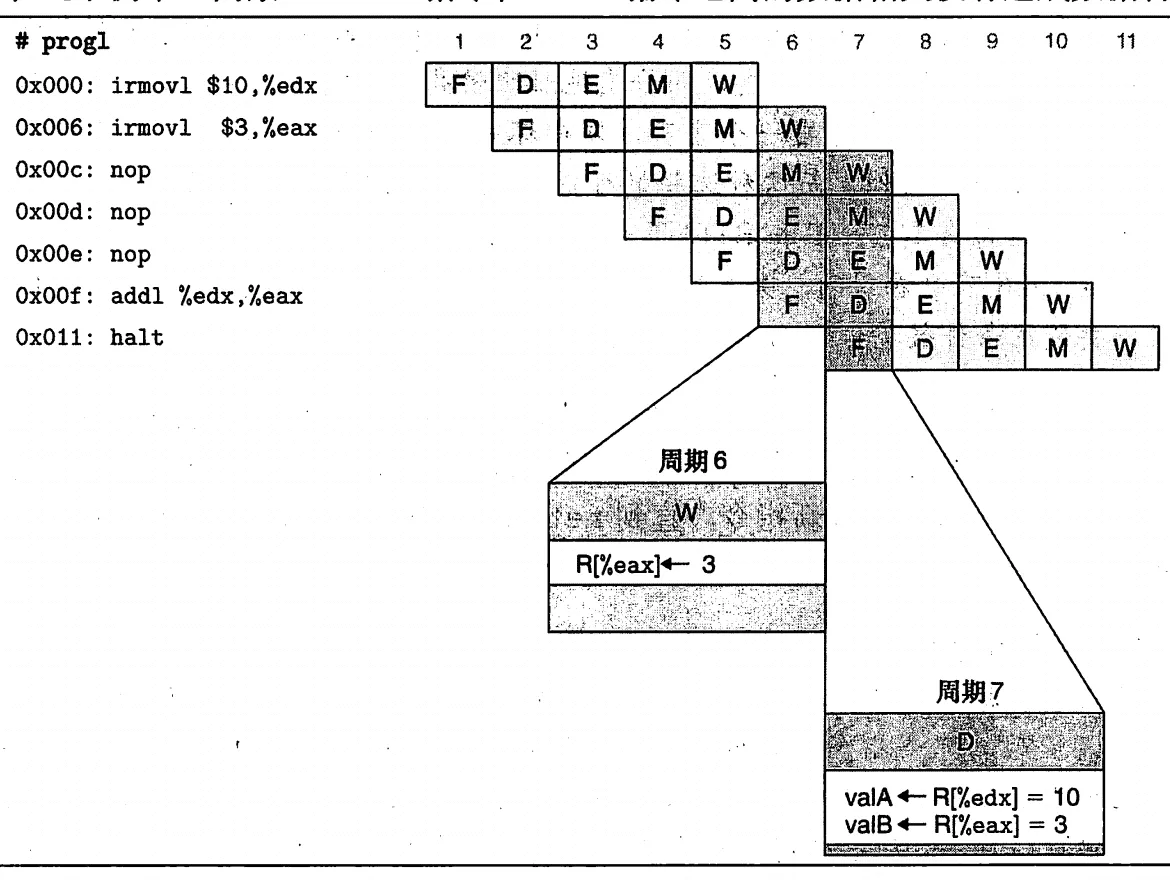
存在数据相关或者控制相关,会产生错误的结果
指令在译码阶段读取寄存器时, 寄存器的ID分别与执行阶段,访存阶段以及写回阶段的目的寄存器进行比较 ,若相等则存在数据相关。
1.用暂停来避免数据冒险
stalling; 让一条指令停止在译码阶段,直到产生它的源操作数的指令通过了写回阶段
方法:插入气泡(bubble)气泡会占据周期
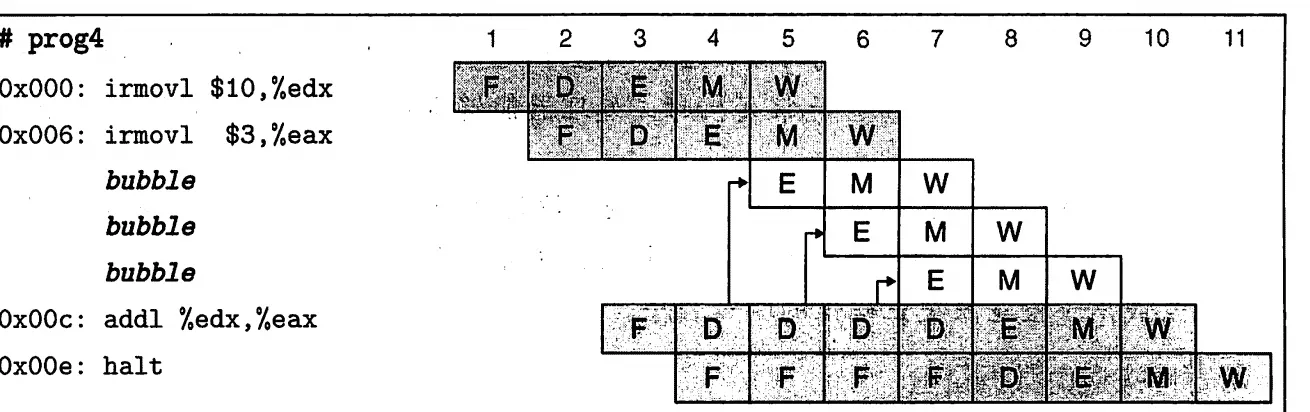 用暂停实现会严重降低流水线的吞吐量
2.用转发来避免数据冒险
转发在基本的硬件结构里添加了额外的数据链接与控制逻辑
增加逻辑块Sel+FwdA和FwdB
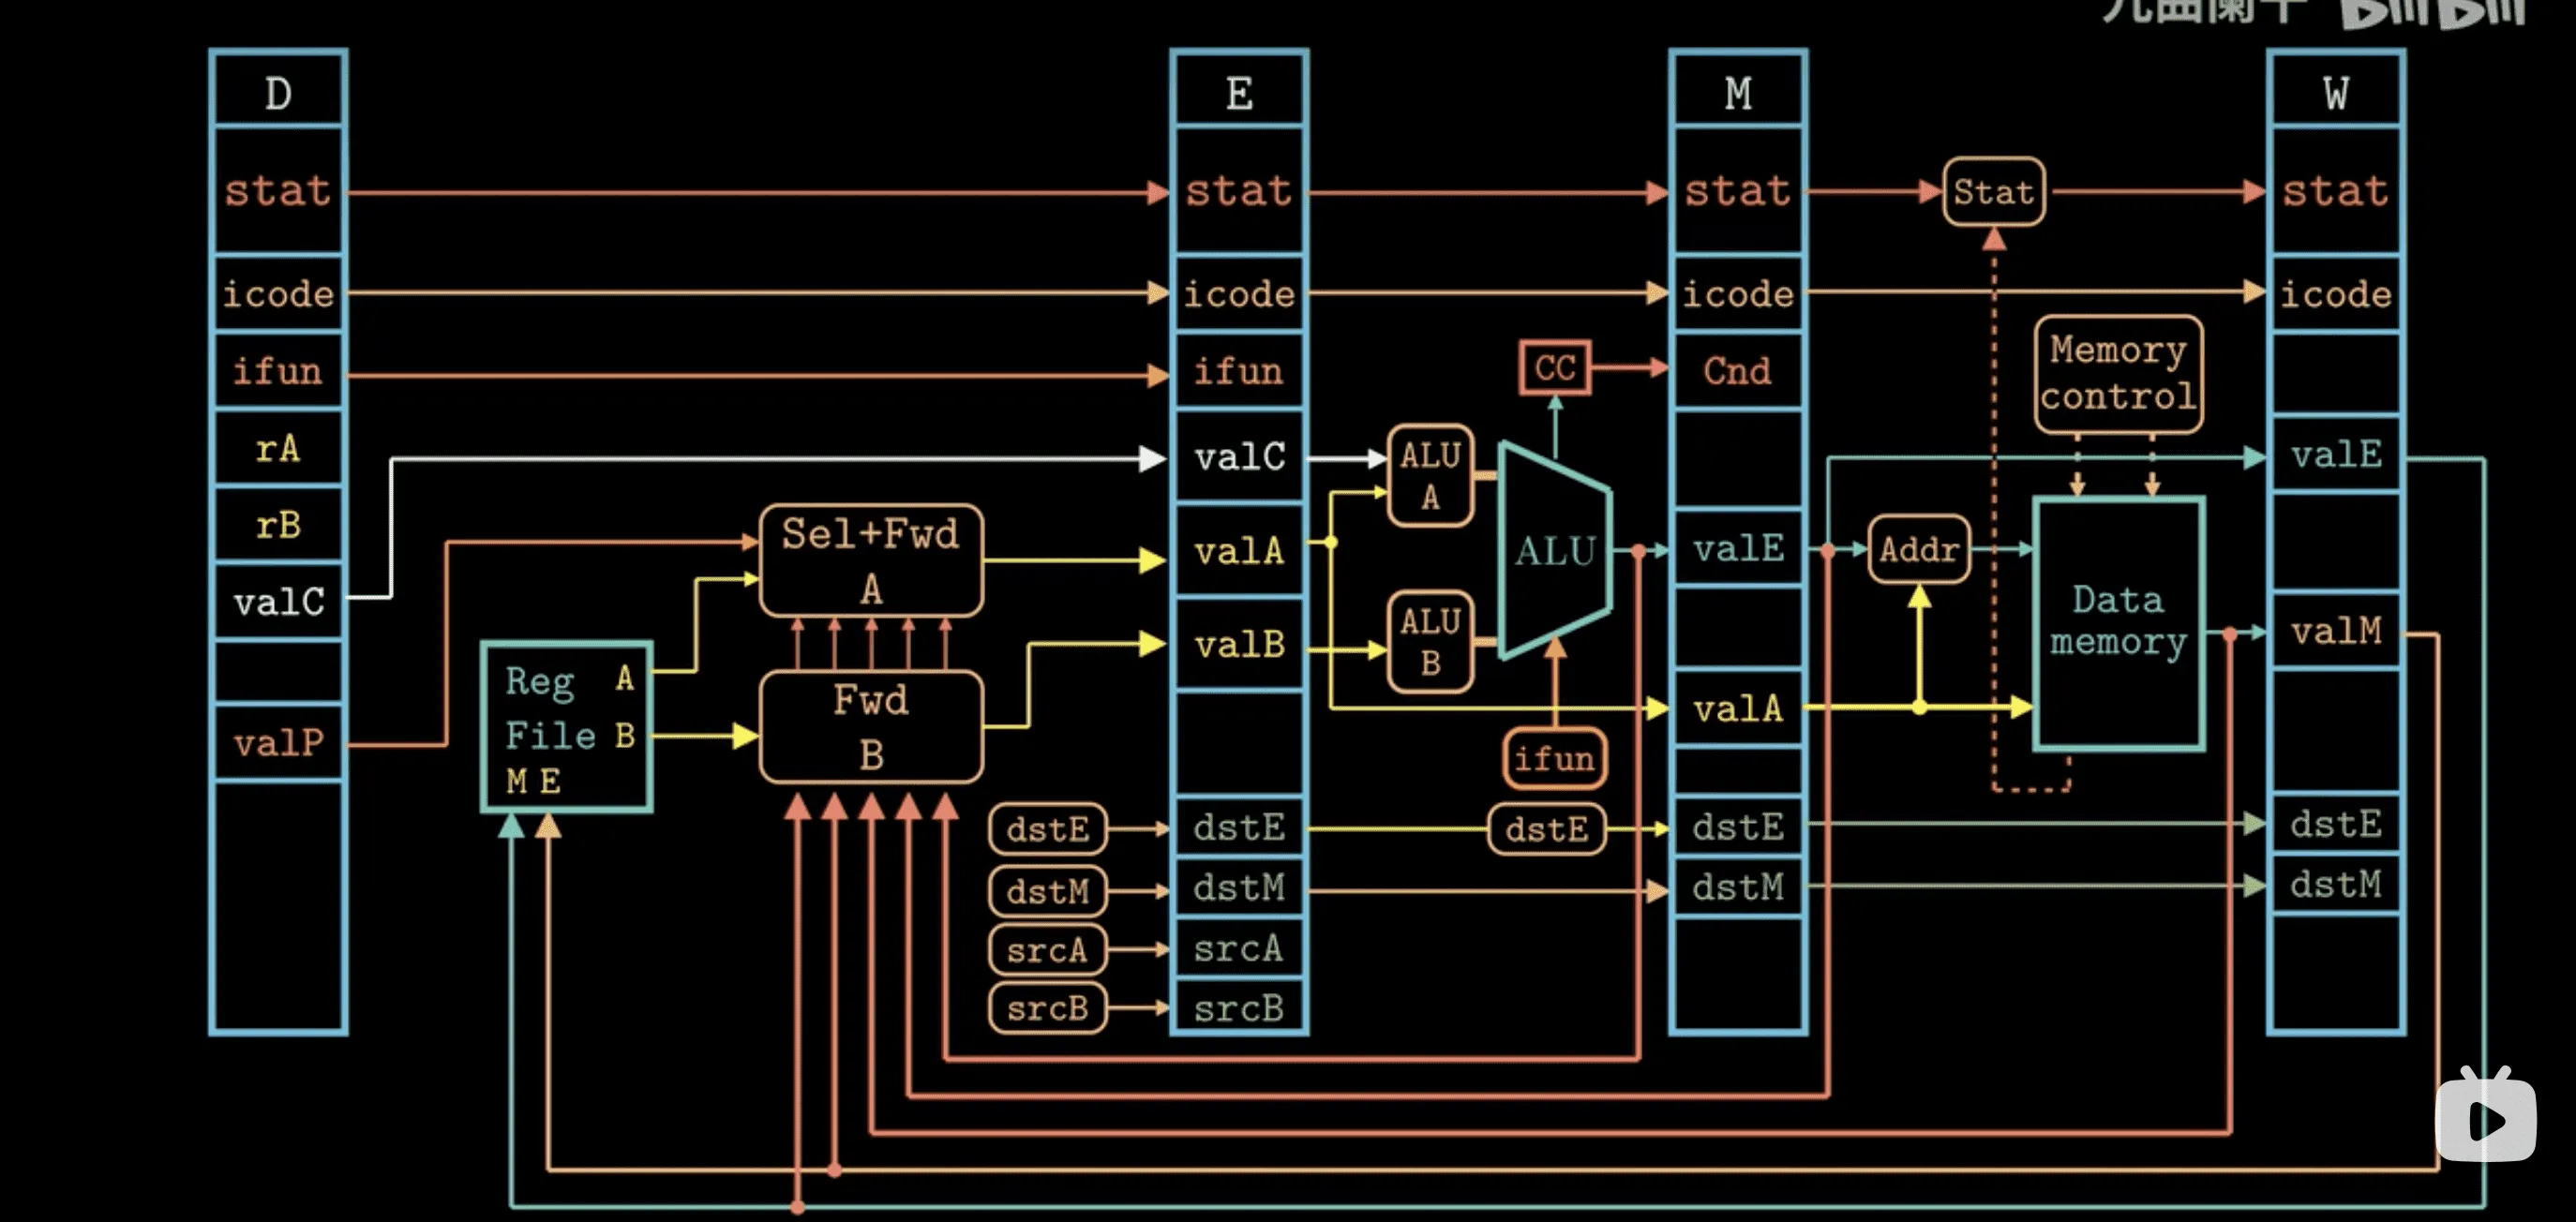 不能单用转发解决的,暂停和转发结合使用
控制冒险:
取指出现ret指令(暂停处理新指令直到ret到达写回阶段)
出现jxx指令:分支预测
假设总是进行跳转;若到达执行阶段发现预测错误则取消这些指令
PIPE各阶段的实现
1.PC选择和取指阶段
word f_pc{
    M_icode == IJXX && !M_Cnd:M_valA;
    W_icode == IRET :W_valM;
    1:F_predPC;
};
word f_predPC =[
    f_icode in {IJXX,ICALL}:f_valC;
    1:f_valP;
];2.译码和写回阶段
//译码阶段由于加入了转发变得复杂
word d_valA =[
    D_icode in {ICALL,IJXX}:D_valP;
    d_srcA == e_dstE :e_valE ;//优先级执行优先
    d_srcA == M_dstM : m_valM ;//访存次之
    d_srcA == M_dstE : M_valE;
    d_srcA == W_dstM : W_valM;//写回最次,先M后E
    d_secA == W_dstE :W_valE;
    1:d_rvalA;
]3.执行阶段
与SEQ差别不大
4.访存阶段
差别不大
性能分析
一个阶段处理了条指令和个气泡
CPI = 1+Cb/Ci
估算:
加载指令(mrmovq和popq)占执行指令的25%,20%会导致冒险1气泡
条件分支指令占20%,40%不选择分支,2气泡
返回指令占2% 3气泡
CPI=1+ 指令频率x条件频率x气泡数